같은 계산, 세 엔진: JS · Go·WASM · WebGPU로 N-body 재보기
// INDEX
WebGPU와 WebAssembly. 이름은 들어봤지만, 이 둘이 무슨 문제를 푸는 기술인지는 몰랐다.
찾아보니 공통점이 있었다. 둘 다 브라우저에서 무거운 계산을 빠르게 돌리려는 기술이다. WebAssembly는 C·Rust·Go로 짠 코드를 거의 네이티브 속도로 실행하고, WebGPU는 그 계산을 GPU의 수천 개 코어에 나눠 던진다.
그렇다면 이 이점은 실제로 얼마나 될까. 말로는 알 수 없다. 무거운 계산을 직접 돌려서, 이 기술들로 풀었을 때와 아닐 때를 나란히 재봐야 한다.
그래서 계산 하나를 세 가지로 구현했다. 평범한 JavaScript, Go로 짜서 WebAssembly로 컴파일한 것, 그리고 WebGPU. 고른 계산은 N-body 중력 시뮬레이션이다. 입자 수천 개가 서로 끌어당기는 이 계산은 무겁고(입자가 2배면 계산은 4배), 잘게 쪼개 병렬로 돌릴 수 있다. WASM과 WebGPU에 이점이 있다면, 바로 이런 계산에서 드러난다.
위는 그 결과물의 미리보기다. 눌러서 전체 화면에서 세 엔진을 직접 바꿔가며 돌려볼 수 있다.
계산 한 스텝, 그리고 그것을 재는 법
먼저 이 계산이 매 순간 무엇을 하는지부터. N-body 시뮬레이션에서 입자 하나는 위치와 속도를 가진다. 한 스텝에서, 각 입자는 나머지 모든 입자로부터 중력을 받는다. 그 힘을 전부 더해 속도를 바꾸고, 바뀐 속도로 위치를 옮긴다. 이 한 번의 갱신이 한 스텝이다. 매 프레임 이 스텝을 반복하면, 입자들이 서로 끌리며 원반을 이루고 돈다.
비용이 어디서 나오는지는 이 설명 안에 이미 있다. 입자 하나의 속도를 구하려면 나머지 전부와의 힘을 더해야 한다. 입자가 6,000개면, 한 스텝에 3,600만 번의 상호작용이 돈다.
이걸 가장 곧이곧대로 옮긴 게 JavaScript 버전이다. 루프 두 개가 겹친다. 바깥은 입자를 하나씩 돌고, 안쪽은 그 입자가 받는 힘을 나머지 전부에서 더한다.
for (let i = 0; i < n; i++) {
  let ax = 0, ay = 0;
  for (let j = 0; j < n; j++) {
    const dx = x[j] - x[i], dy = y[j] - y[i];
    const inv = 1 / Math.sqrt(dx * dx + dy * dy + SOFT2);
    const f = G * inv * inv * inv;
    ax += dx * f; ay += dy * f;
  }
  vx[i] += ax * dt; vy[i] += ay * dt;  // 속도 갱신
}
// 그다음 위치 갱신: x[i] += vx[i] * dt ...
두 번째 구현은 같은 물리를 Go로 쓰고 WebAssembly로 컴파일한 것이다. Go 코드는 위 JavaScript와 거의 한 줄씩 대응한다. 다른 건 실행 방식뿐이다. (표준 Go 컴파일러가 뽑는 WebAssembly는 런타임이 통째로 실려 수 MB가 되기에, 작게 뽑아주는 TinyGo로 컴파일했다. 결과물은 4KB다.)
세 번째는 WebGPU다. 앞의 둘은 CPU에서 입자를 하나씩 순서대로 계산한다. WebGPU는 이 계산을 GPU로 보낸다. GPU는 코어가 수천 개라, 입자 수천 개의 속도를 한꺼번에 계산할 수 있다. 코드에서는 “스레드 하나가 입자 하나를 맡는다”로 나타난다.
fn csVel(@builtin(global_invocation_id) gid: vec3<u32>) {
  let i = gid.x;                        // 이 스레드가 맡은 입자
  var a = vec2<f32>(0.0);
  for (var j = 0u; j < count; j++) {   // 나머지 전부와의 힘
    let d = pos[j] - pos[i];
    let inv = inverseSqrt(dot(d, d) + soft2);
    a += d * (inv * inv * inv);
  }
  vel[i] += a * (g * dt);
}
한 가지 주의가 있다. 위치 갱신은 속도 갱신과 분리해 두 번에 나눠 한다. 수천 개의 스레드가 동시에 도는데, 어느 스레드가 위치를 먼저 바꾸면 다른 스레드가 읽는 값이 어긋나기 때문이다. 그래서 모든 속도를 먼저 구하고, 그다음에 위치를 옮긴다.
이제 무엇을 잴지 정할 차례다. 세 엔진은 두 가지 일을 한다. 계산(step)과, 그 결과를 화면에 점으로 찍는 렌더링. 궁금한 건 계산 속도다. 그래서 step만 재고 렌더링은 뺀다.
여기서 WebGPU에 함정이 하나 있다. JavaScript와 WebAssembly는 step 함수가 반환되면 계산도 끝나 있다. 앞뒤로 시간을 재면 그만이다. WebGPU는 다르다. GPU에 계산을 시키는 명령은 던지는 즉시 반환된다. 실제 계산은 GPU가 뒤에서 따로 한다. 그래서 명령을 던진 시점부터 반환까지를 재면, 계산 시간이 아니라 명령을 넘긴 시간을 잰다. WebGPU가 실제보다 터무니없이 빠르게 찍힌다. 그래서 GPU가 일을 실제로 끝낼 때까지 기다린 뒤에야 시간을 멈춘다.
결과
랩의 “벤치 실행”은 세 엔진을 같은 입자 수로 차례대로 돌리고, step 하나에 걸린 평균 시간을 잰다. 입자 2,000개와 20,000개에서 측정한 결과는 아래와 같다.
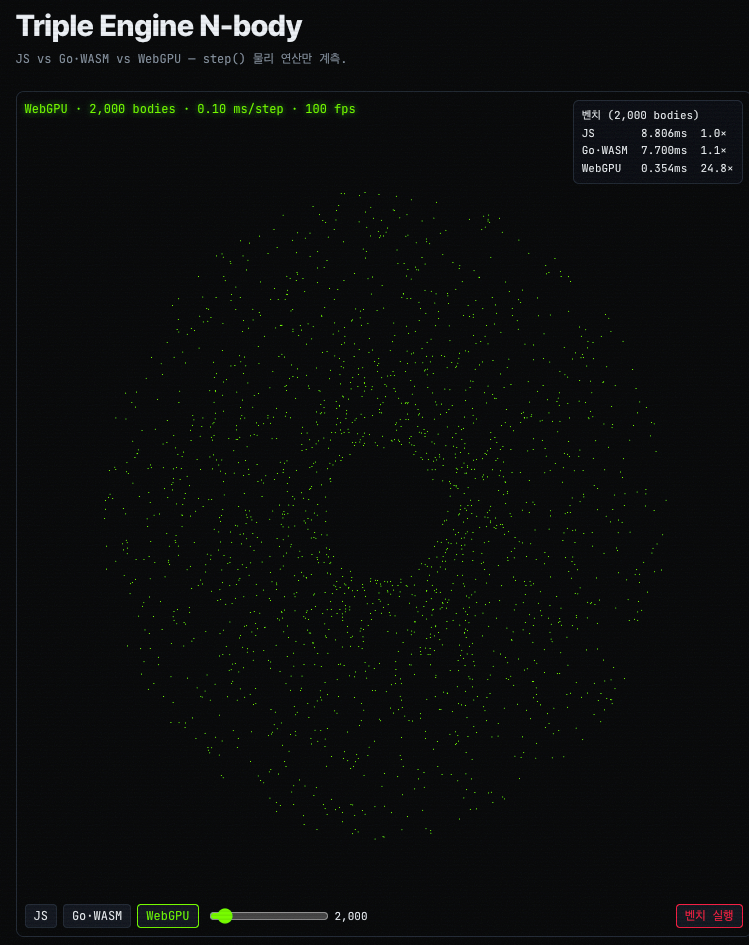
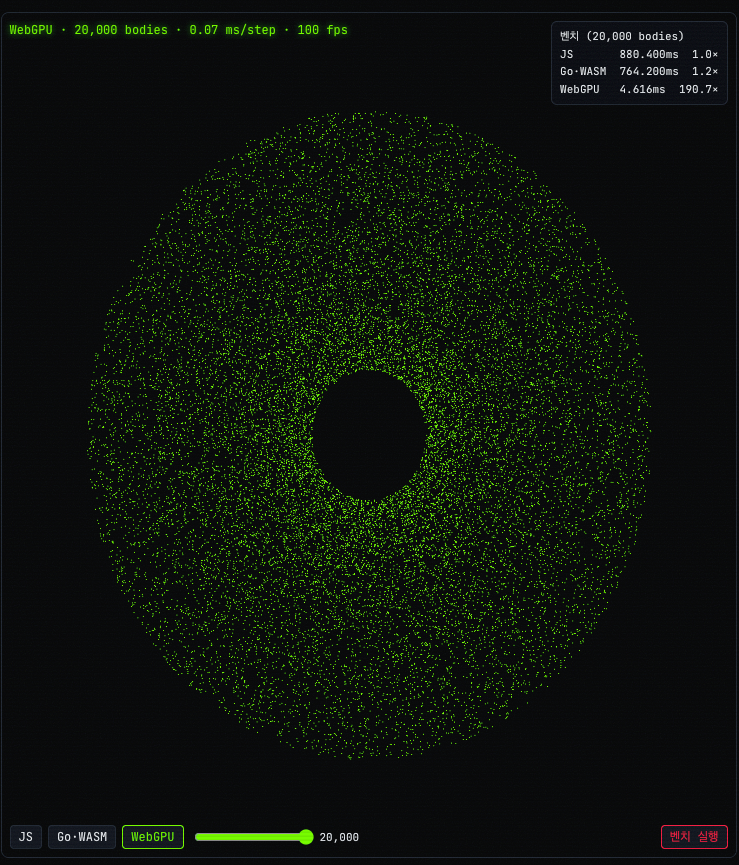
WebGPU부터 보자. 2,000개에서 JS보다 24.8배, 20,000개에서는 190.7배 빨랐다. 눈여겨볼 건 격차가 벌어진다는 점이다. 입자를 10배로 늘렸더니 우위가 24배에서 190배로 커졌다. 20,000개에서 JS는 한 스텝에 880ms가 걸렸지만, WebGPU는 4.6ms였다. 이유는 계산의 모양에 있다. 입자가 늘면 상호작용은 제곱으로 늘어난다. CPU는 그 계산을 하나씩 처리하지만, GPU는 수천 개 코어에 나눠 담는다. 문제가 커질수록, 나눠 담는 쪽이 이긴다.
Go·WASM은 그렇지 않았다. 2,000개에서 1.1배, 20,000개에서 1.2배. 입자 수와 상관없이 JS를 겨우 앞섰다. WebAssembly로 짰으니 격차가 더 벌어질 줄 알았는데, 차이는 크지 않았다. 왜 생각보다 크게 나지 않았을까?
WASM은 왜 JS를 압도하지 못했나
먼저 전제 하나를 깨야 한다. “JavaScript는 느리다”는 말은 이 경우엔 맞지 않는다.
JavaScript도 실행 중에 기계어로 컴파일된다. 이걸 JIT(Just-In-Time) 컴파일이라 한다. 코드가 처음 돌 때는 한 줄씩 해석하는 인터프리터로 실행되지만, 같은 코드가 자주 반복되면 브라우저가 그걸 감지해 최적화된 기계어로 바꿔치기한다. Chrome의 V8에서는 TurboFan이라는 컴파일러가 그 일을 한다. 그러니까 뜨겁게 도는 JS 루프는 이미 기계어로 돌고 있는 셈이다.
그리고 이 실험의 물리 루프는, 하필 JIT가 가장 잘 다루는 형태였다.
- 같은 연산이 수백만 번 반복된다.
- 다루는 값이 전부 숫자 하나의 타입이다. 타입이 바뀌지 않으니 최적화가 도중에 풀릴 일이 없다.
- 객체를 만들지 않으니, 안 쓰는 메모리를 치우는 GC(가비지 컬렉션)가 끼어들 틈도 없다.
이런 조건에서 TurboFan은 거의 최적에 가까운 기계어를 만든다. 여기서 핵심은, 언어를 바꿔도 곱하고 더하는 횟수 자체는 줄지 않는다는 것이다. JS든 WASM이든 그 3,600만 번의 계산은 똑같이 해야 한다. 그러니 WASM으로 갈아탄다고 크게 빨라질 여지가 없었다.
그럼 WASM은 원래 어디서 빠른가. 강점은 이 벤치의 조건 바깥에 있다. 타입이 뒤섞이거나 GC 부담이 커서 JIT가 최적화를 유지하지 못하는 코드에서. 코덱·암호·압축처럼 정수와 비트를 다루는 작업에서. 이미 있는 C·Rust 라이브러리를 그대로 웹으로 가져올 때. 예열 없이 첫 순간부터 일정한 속도가 필요할 때.
그리고 하나 더. 이 계산에 가장 크게 먹힐 카드가 있었는데, 이번엔 쓰지 않았다. SIMD다. JS도 WASM도 값을 하나씩 처리하는 평범한 코드였다. 정리하면 이 벤치마크는 JS와 WASM의 차이가 크게 벌어지지 않는 실험 환경이었던 것이다. 그래서 그 SIMD를, 실제로 써봤다.
SIMD를 더한 네 번째 엔진
그 SIMD가 정확히 뭔지, 왜 빨라지는지, 그리고 왜 Go로는 못 했는지 하나씩 보자.
SIMD가 뭔가
SIMD는 웹 기술이 아니라 CPU가 계산하는 방식이다. 이름 그대로 Single Instruction, Multiple Data — 명령 하나로 여러 데이터를 처리한다.
마트 계산대로 비유하면 이렇다. 보통은 계산원이 물건을 하나씩 바코드로 찍는다. 100개면 100번 찍는다. SIMD는 상자에 담긴 네 개를 스캐너 한 번에 찍는 방식이다.
컴퓨터로 옮기면, 1+1, 2+2, 3+3, 4+4 네 덧셈이 있을 때 보통 CPU는 네 번에 나눠 계산한다. SIMD는 명령 하나로 네 개를 동시에 끝낸다. 우리 N-body의 안쪽 루프가 딱 이 모양이다. 입자마다 똑같은 산술을 반복하니, 네 입자를 한 묶음으로 처리하면 명령 수가 최대 4분의 1로 준다.
왜 하필 네 개인가
여기서 f32x4가 나온다. 풀면 “32비트 float 4개”다.
CPU에는 SIMD 전용으로 128비트짜리 레지스터(계산용 임시 저장 공간)가 있다. float 하나가 32비트니까, 128 ÷ 32 = 4. 이 그릇 하나에 float이 정확히 네 개 들어간다. 그래서 SIMD 곱셈 명령 하나가 네 개를 동시에 곱한다. 여덟 개가 아니라 네 개인 건, 그릇이 딱 그만큼이기 때문이다.
데이터가 붙어 있어야 한다
SIMD로 네 입자의 x를 한 번에 읽으려면, 그 x 네 개가 메모리에 나란히 붙어 있어야 한다. 스캐너로 네 개를 한 번에 찍으려면 네 개가 한 상자에 모여 있어야 하는 것과 같다.
그런데 앞의 엔진들은 입자 하나를 [x, y, vx, vy] 순으로 붙여 저장했다. 이 방식을 AoS(Array of Structs)라 한다. 이러면 x들이 네 칸씩 떨어져 있어 한 번에 못 읽는다.
그래서 SIMD 엔진은 저장 방식을 바꿨다. x는 x끼리, y는 y끼리 따로 모았다. 이건 SoA(Struct of Arrays)다. 이제 x 네 개가 딱 붙어 있어 명령 하나로 읽어 f32x4에 담을 수 있다. SIMD를 쓰려면 계산만 바꾸는 게 아니라 데이터 배치까지 바꿔야 한다.
왜 Go로는 안 되고 Rust인가
문제가 하나 있었다. 이 SIMD를 앞서 쓰던 Go로는 짤 수 없었다.
SIMD를 쓰는 길은 둘 중 하나다. 컴파일러가 알아서 내 코드를 SIMD 명령으로 바꿔주거나(자동 벡터화), 내가 SIMD 명령을 코드에서 직접 부르거나(인트린식).
Go는 둘 다 막혀 있었다. Go에는 WASM SIMD 명령을 직접 부르는 인트린식이 없고, TinyGo가 이 루프를 알아서 SIMD로 바꿔주지도 않았다. 그래서 Go로 뽑은 WASM은 결국 하나씩 계산하는 명령만 쓴다. 트럭에 터보가 달려 있어도 켤 스위치가 없는 셈이다.
Rust에는 그 스위치가 있다. f32x4_mul 같은 함수가 WASM의 SIMD 명령에 그대로 대응한다. 그래서 SIMD 버전만 Rust로 따로 짜서 네 번째 엔진으로 붙였다.
결과
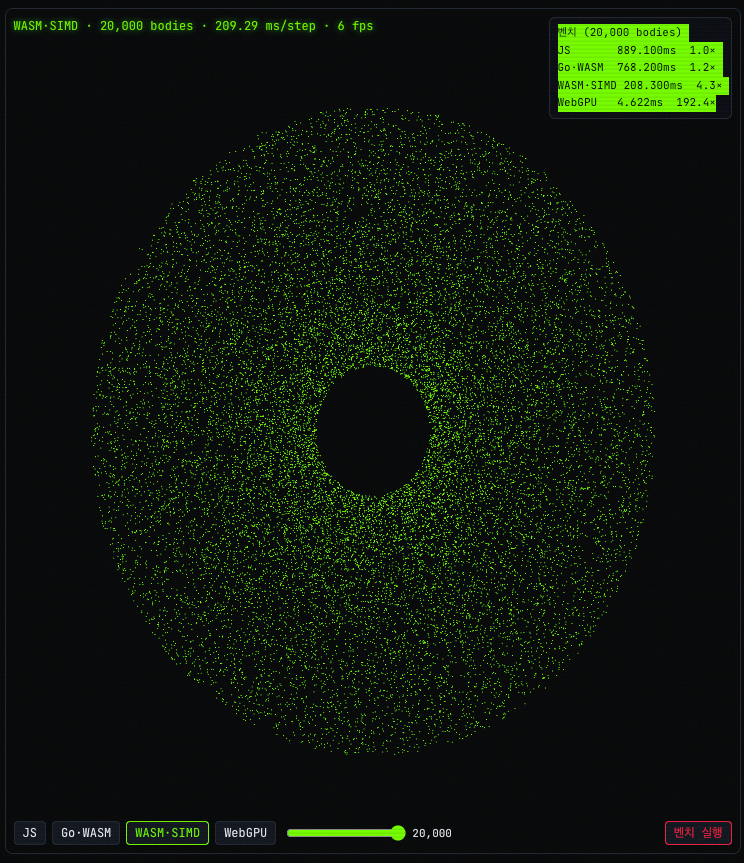
입자 20,000개에서 Go·WASM은 한 스텝에 768ms가 걸렸다. 같은 계산을 SIMD로 짠 WASM·SIMD는 208ms였다. 약 3.7배 빠르다. JS 기준으로는 4.3배. 앞에서 JS를 겨우 1.2배 앞섰던 WASM이, SIMD를 얹자 확실히 벌어졌다.
왜 딱 4배는 아닐까. 네 개를 한 번에 처리하는 건 안쪽 루프의 산술뿐이다. 네 레인의 값을 마지막에 하나로 합치는 과정, sqrt, 메모리를 오가는 시간은 그대로 남는다. 그래서 3~4배가 현실적인 이득이다.
그래도 WebGPU는 못 따라간다. 같은 20,000개에서 WebGPU는 4.6ms, JS의 192배다. SIMD가 CPU에서 한 번에 네 개를 처리한다면, GPU는 한 번에 수천 개를 처리한다. 병렬의 규모가 다르다.
마치며
WASM은 브라우저의 한계에서 나왔다. 브라우저는 오래도록 JavaScript만 알아들었고, JavaScript로는 3D 게임이나 영상 편집 같은 무거운 작업이 버거웠다. WASM은 C·Rust·Go로 짠 고성능 코드를 설치 없이 브라우저에서 네이티브에 가까운 속도로 돌리려고 만들어졌다. 그 쓰임은 브라우저에 머물지 않는다. WASI라는 표준을 통해 같은 바이너리가 서버와 엣지에서도 돈다.
WebGPU는 다른 문제에서 나왔다. 웹에는 GPU로 일반 계산을 시킬 정식 길이 없었다. WebGL은 그림 전용이었고, 계산은 편법이었다. WebGPU는 브라우저에서 GPU로 렌더링과 범용 계산을 모두 할 수 있게 했다.
이 덕분에 Figma 같은 그래픽 툴이 브라우저에서 돌고, 브라우저가 영상을 인코딩하고, 웹캠 배경을 실시간으로 지운다. 서버로 보내 처리하던 일을 점점 더 브라우저가 직접 한다.
이번 실험은 그 성능을 눈으로 확인한 것이다. 같은 계산을 네 방식으로 돌리니 JS와 plain WASM은 붙어 있었고, SIMD로 4배, WebGPU로 190배가 벌어졌다. 도구마다 잘 맞는 문제가 따로 있다.