쿠버네티스 오토 스케일링의 핵심: Metrics Server 이해하기
// INDEX
쿠버네티스를 운영하다 보면, 클러스터의 노드나 파드가 실제로 얼마나 리소스를 사용하는지 확인하고 자동으로 리소스를 확장 및 축소하는 일이 매우 중요합니다.
쿠버네티스에서는 HPA (Horizontal Pod Autoscaling), VPA (Vertical Pod Autoscaling)와 같이 pod를 자동으로 수평 및 수직 스케일링 해주는 기능을 제공하고 있습니다.
해당 기능은 자동 확장을 CPU 사용률, 메모리 사용률 등과 같은 지표를 스케일링의 기준으로 사용하기 때문에 실시간으로 메트릭을 안정적으로 수집하는 일이 중요합니다.
이를 위해 쿠버네티스는 메트릭 수집과 제공을 위한 공식적인 컴포넌트인 Metrics Server를 제공합니다.
Metrics Server
Metrics Server는 쿠버네티스 클러스터에서 실행 중인 노드와 파드의 CPU 및 메모리 사용량을 수집하고 제공하는 컴포넌트입니다.
여기서 주의할 점은 Metrics Server 가 수집하는 지표는 시스템 모니터링의 용도가 아닌 autoscaling 의 조건으로 사용된다는 점입니다.
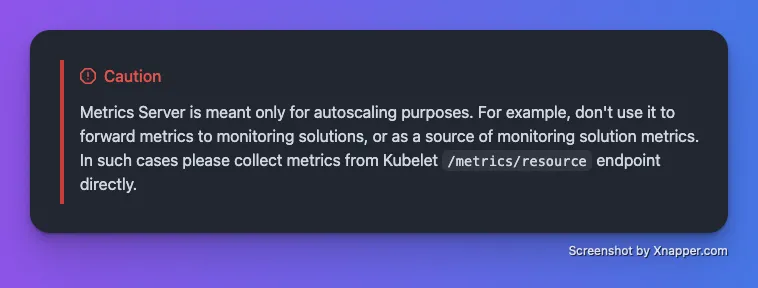
이에 대해서는 Metrics Server 의 공식 Github Repo에서도 주의사항으로 명시하고 있습니다.
https://github.com/kubernetes-sigs/metrics-server
Metrics Server 는 오직 오토스케일리이 목적이다. 예를 들어 모니터링 설루션으로 메트릭을 전달하거나 하는 데 사용해서는 안된다. 만약 모니터링을 위한 메트릭이 필요한 경우 /metrics/resource 엔드포인트에서 수집하라.
Metrics Server는 클러스터 내부의 각 노드로부터 메트릭 데이터를 수집하고, 이를 metrics.k8s.io API 그룹을 통해 외부에 노출합니다.
이 API는 kubectl top 명령어나 Horizontal Pod Autoscaler(HPA), Vertical Pod Autoscaler(VPA) 같은 오토스케일링 컨트롤러에 의해 사용됩니다.
리소스 메트릭 파이프라인
Metrics Server는 쿠버네티스에서 제공하는 메트릭 수집 구조에서 하나의 구성요소입니다.
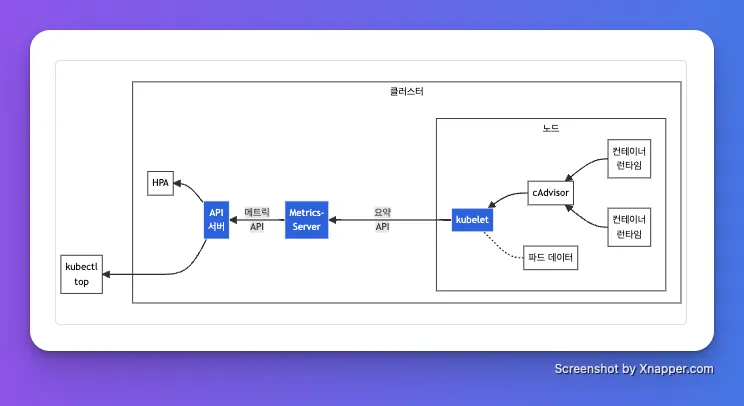
리소스 메트릭 파이프라인이란, 컨테이너 런타임에서 시작되어 메트릭을 수집하고 처리해 Kubernetes 의 API로 제공되기까지의 전체 흐름을 의미합니다.
이 파이프라인은 다음과 같은 순서로 구성됩니다.
https://github.com/kubernetes-sigs/metrics-server
쿠버네티스 리소스 메트릭 파이프라인에서 메트릭이 수집되고 API 서버에서 제공되기까지의 과정을 순차적으로 설명하면 다음과 같습니다.
- 컨테이너 런타임에서 메트릭 생성
- 각 노드의 컨테이너 런타임은 CPU, 메모리 등의 리소스 사용량 데이터를 생성합니다.
- cAdvisor가 메트릭 수집
- Kubelet 설치 시 포함되어 설치되는 cAdvisor가 컨테이너 런타임에서 리소스 메트릭을 수집합니다.
- kubelet이 메트릭 수집
- kubelet은 cAdvisor로부터 수집한 메트릭과 파드 정보를 취합합니다.
- Metrics Server가 kubelet에서 메트릭 수집
- 클러스터 내부의 Metrics Server는 각 노드의 kubelet에 요약 API 를 호출하여 메트릭을 주기적으로 가져옵니다.
- API 서버가 메트릭 제공
- Metrics Server는 수집한 메트릭을 쿠버네티스 API 서버에 메트릭 API 형태로 노출합니다.
- kubectl top 또는 HPA에서 API 서버를 통해 메트릭 조회
- 사용자는 kubectl top 명령어로 리소스 사용량을 확인합니다.
- api 서버는 사용자 요청을 받아 metrics 서버로 요청을 전달합니다.
위와 같은 흐름을 통해 컨테이너의 리소스 사용 정보가 실시간으로 API 형태로 전달됩니다. Metrics Server는 이 흐름의 중간에서 데이터 집계와 API 제공을 담당하는 핵심 구성 요소입니다.
위 흐름에서 수집된 메트릭은 etcd와 같은 영구 저장소가 아닌, 메모리(in-memory) 에 저장됩니다. 최신 값만 유지하며, 메트릭 서버가 재시작되면 이전 값은 모두 유실됩니다.
Metrics Server 설치
GKE, EKS와 같은 Managed Kuberentes 환경에선 metrics server 가 설치되어 있을 수 있습니다. 그게 아닌 native k8s 환경인 경우 metrics server를 직접 설치해야 합니다.
Metrics Server는 YAML 매니페스트에서 직접 설치하거나 공식 Helm 차트를 통해 설치할 수 있습니다.
yaml 매니페스트를 사용해서 설치하는 방법은 다음과 같습니다.
kubectl apply -f 해당 명령어를 수행하면 설치 과정에서 생성된 여러 kubernetes의 오브젝트 들이 표시됩니다.
간략하게 살펴보면 RBAC 권한 설정을 위해 service account, cluster role, cluster role binding, role binding을 사용합니다.
service 오브젝트는 네트워킹, deployment로 metrics server의 application 이 pod 형태로 배포되며, api registration 을 통해서 새로운 API 그룹을 등록합니다.
아래 명령어를 통해서 metrics server 의 pod의 상태를 확인해 볼 수 있습니다.
kubectl get po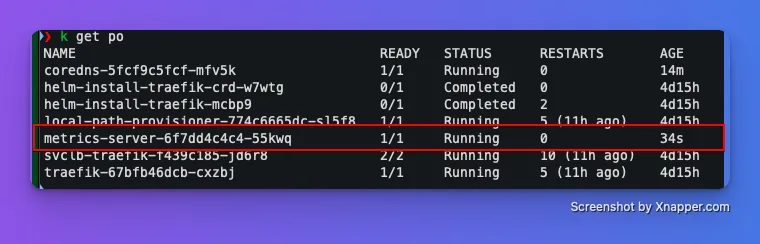
kubectl get pod 로 metrics server pod 상태 확인
Metrics server 사용하기
Metrics server 가 설치되어 있으면 metrics.k8s.io API를 통해 노드와 파드의 리소스 사용량을 조회할 수 있습니다.
다음 명령어로 node와 pod의 리소스 사용량 확인이 가능합니다.
kubectl top nodes
kubectl top pods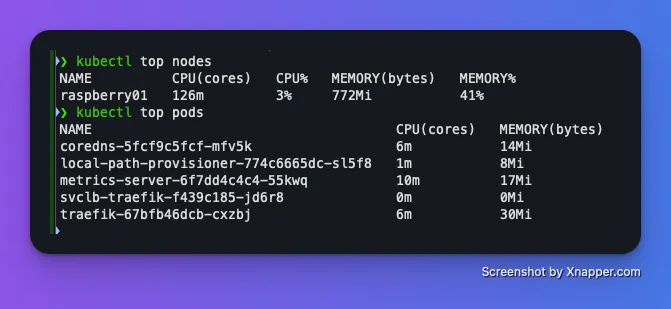
kubectl top 명령어는 내부적으로 metrics.k8s.io API 호출을 사용합니다.
kubectl get --raw "/apis/metrics.k8s.io/v1beta1/nodes" | jq '.'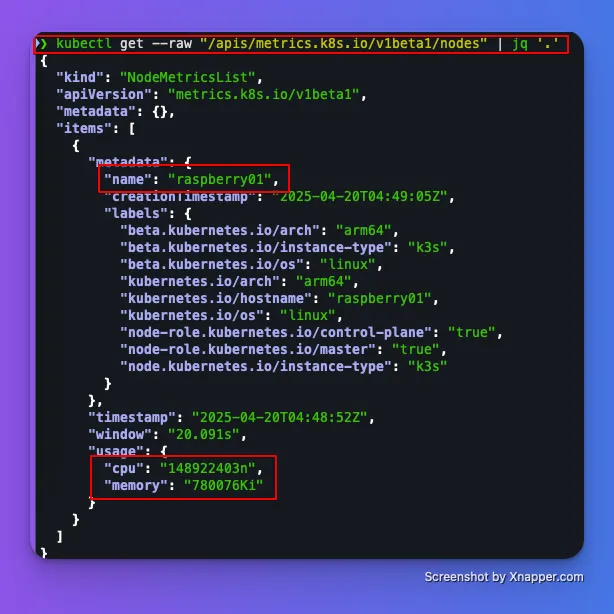
전체 노드에 대해서 규격화된 json 형식으로 응답을 받게 됩니다.
pod 또한 동일한 방식의 API 호출로 조회할 수 있습니다.
kubectl get --raw "/apis/metrics.k8s.io/v1beta1/namespaces/kube-system/pods" | jq '.'pod의 경우 namespace scope로 pod 메트릭이 조회됩니다.
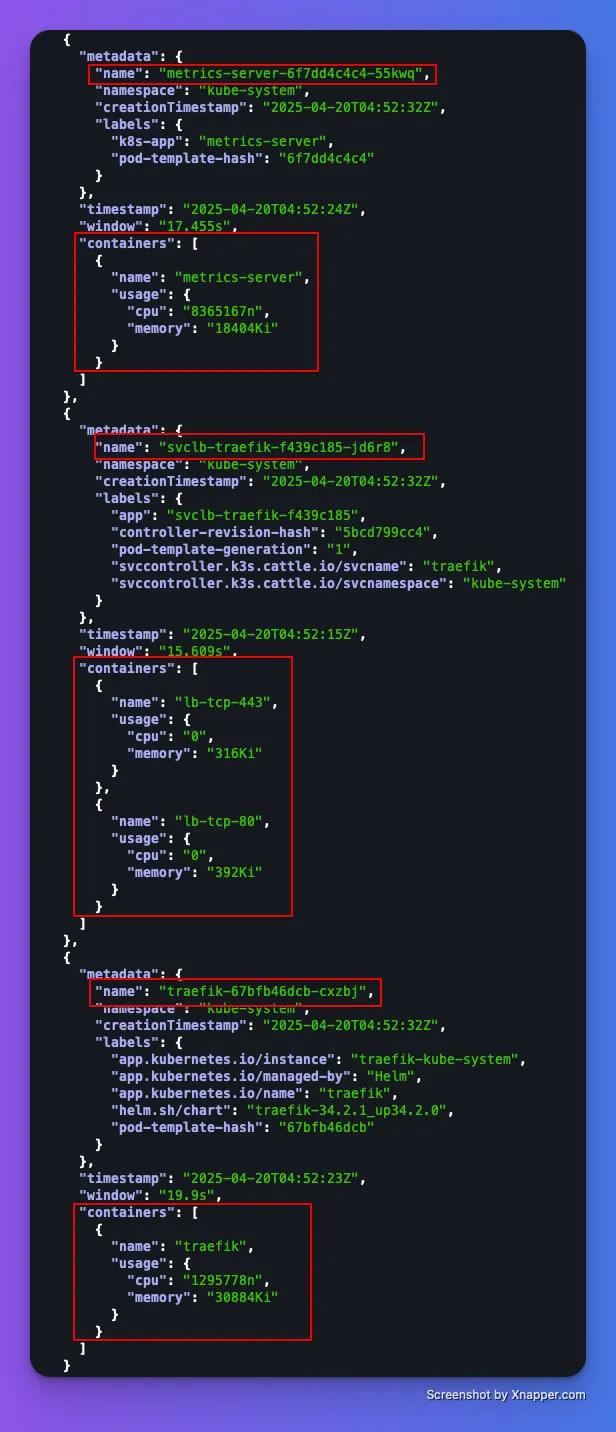
kubectl top 명령어는 위와 같이 metrics.k8s.io의 API 그룹에 대한 node와 pod 메트릭 정보 응답을 가독성 좋게 가공해서 출력하는 명령어입니다.
메트릭 단위에 대한 이해
메트릭 API가 제공하는 값은 단순 숫자가 아닙니다. 각각의 단위와 의미를 이해해야 제대로 해석할 수 있습니다.
CPU
CPU 메트릭은 나노초 단위 누적 시간(n)으로 제공되며, 특정 시간 내에서의 평균 사용량을 의미합니다.
쿠버네티스에서 1 CPU는 일반적으로 가상 CPU(vCPU) 하나 또는 인텔 기반 프로세서의 하이퍼스레드 하나를 뜻합니다.
top 명령어로 보이는 CPU는 m 단위로 표시됩니다. m 은 millicore(1000 분의 1 코어)를 의미합니다. 예를 들어 250m의 경우 0.25 CPU 사용을 의미합니다.
메모리
메모리는 실제 사용 중인 메모리인 워킹 셋(Working Set) 기준으로 측정됩니다. 이는 현재 실제로 사용 중이어서 해제할 수 없는 메모리로, 캐시 메모리도 일부 포함될 수 있습니다.
측정 방식은 호스트 OS에 따라 다르며 완전한 정확도보다는 운영에 참고할 수 있는 수준의 추정값입니다.
top 명령어로 보이는 Memory는 Mi 또는 Ki 단위로 표시됩니다. Mi는 Mebibyte(2^20 바이트)를 의미하고, Ki 는 Kibibyte (2^10 바이트) 를 의미합니다. 예를 들어 128Mi는 128M의 메모리를 사용 중을 의미합니다.
HPA, VPA와 연계
Metrics Server의 가장 핵심적인 활용 사례는 오토스케일링입니다.
HorizontalPodAutoscaler(HPA)와 VerticalPodAutoscaler(VPA)는 Metrics API를 기반으로 리소스 사용량을 분석하여, 자동으로 파드 수를 조정하거나 리소스 요청량을 재조정합니다.
아래는 HPA 설정 예제입니다.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: example-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-deployment
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
이 설정은 CPU 사용률이 70%를 넘으면 파드 수를 늘리고, 70% 이하로 떨어지면 줄이는 방식으로 동작합니다.
이 판단을 위한 실시간 메트릭은 모두 Metrics Server를 통해서 요청하기 때문에 HPA, VPA 사용을 위해선 반드시 Metrics server 가 클러스터에 구성되어 있어야 합니다.
마무리
Metrics Server는 쿠버네티스의 오토스케일링과 리소스 사용량 확인 역할을 하는 컴포넌트입니다.
단순한 모니터링 도구가 아닌 클러스터 내에서 리소스를 효율적으로 사용할 수 있도록 데이터를 제공하는 중요한 인프라 구성 요소로 사용됩니다.
리소스 메트릭 파이프라인의 개념을 이해하고, Metrics Server의 구조와 흐름을 정확히 파악하면, 더 안정적이고 유연한 클러스터 운영이 가능해집니다.
다음에는 대규모의 클러스터 환경에서 Metrics Server의 HA 구성과 Metrics Server 의 Resource Request 등에 대해서 학습하고 공유하겠습니다. 감사합니다.